
Nota de publicación: Este análisis técnico forma parte del desarrollo e investigación académica llevados a cabo en la asignatura de Sistemas Operativos de la Universidad Nacional Abierta (UNA), conectando los fundamentos teóricos de la ingeniería con soluciones de infraestructura en entornos reales (RAID 6).
Vulnerabilidad de los datos en la era del bitrate masivo
En el ecosistema digital contemporáneo, los datos no solo representan registros informáticos; constituyen el activo estratégico y financiero más valioso de cualquier organización.Dentro de la industria del entretenimiento y el sector cinematográfico, esta premisa adquiere dimensiones críticas: el material en crudo (footage sin editar) capturado por cámaras de resolución 4K, 6K u 8K genera flujos de datos secuenciales masivos que saturan las arquitecturas de almacenamiento tradicionales.En este escenario, la pérdida de un solo bloque de información no se traduce únicamente en un fallo de software; implica la destrucción de jornadas de rodaje irreemplazables, el aumento exponencial de los costes de producción y el potencial colapso financiero de un proyecto.
Frecuentemente se asume de manera errónea que las estrategias de copia de seguridad tradicionales (como los respaldos offline o en la nube) son suficientes para mitigar estos riesgos. Sin embargo, para un entorno de producción en tiempo real, el verdadero desafío no es solo la conservación del dato, sino la Alta Disponibilidad y la continuidad operativa. Un estudio de cine no puede permitirse detener sus islas de edición no lineal durante días enteros mientras se descarga o reconstruye un backup externo. La infraestructura de almacenamiento masivo debe ser capaz de absorber fallos de hardware en caliente sin interrumpir el servicio ni degradar críticamente el rendimiento.
Tradicionalmente, configuraciones como RAID 5 han sido el estándar para equilibrar capacidad y tolerancia a fallos. No obstante, la evolución tecnológica hacia unidades de disco duro de gran capacidad (muchos Terabytes por unidad) ha dejado obsoletos los mecanismos de paridad simple. Cuando un disco de alta densidad falla, el proceso de reconstrucción (resilver) somete al resto de las unidades a un estrés mecánico y de lectura extremo durante días. Es precisamente en esta ventana de vulnerabilidad donde la probabilidad de una segunda avería aumenta drásticamente, provocando la pérdida catastrófica de los datos en un sistema RAID 5. Como respuesta de ingeniería a este problema, el nivel RAID 6 surge como la arquitectura técnica más robusta y necesaria para garantizar la resiliencia en subsistemas de almacenamiento masivo profesionales.
¿Qué es RAID 6? Anatomía del subsistema de doble paridad distribuida
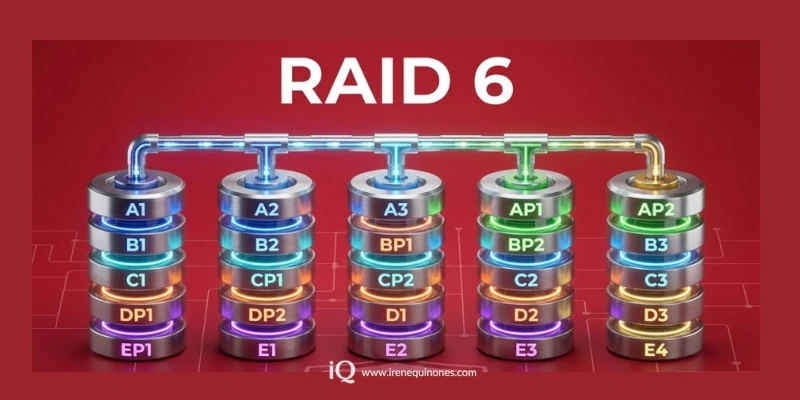
El acrónimo RAID 6 (Redundant Array of Independent Disks) define un subsistema de almacenamiento masivo avanzado diseñado bajo el principio de doble paridad distribuida. A diferencia de sus predecesores, la premisa fundamental de RAID 6 es su capacidad para mantener la integridad del sistema y la disponibilidad absoluta de los datos incluso ante la pérdida simultánea de hasta dos unidades físicas de almacenamiento del arreglo.
Para comprender la robustez de este subsistema, es necesario analizarlo a través de sus tres pilares matemáticos y estructurales:
Fragmentación de datos (Striping)
Los archivos multimedia pesados no se almacenan de manera lineal o consecutiva en un único disco. El sistema operativo y el controlador dividen la información en segmentos lógicos llamados bloques (usualmente optimizados entre 512 KB y 1 MB para flujos secuenciales de vídeo). Estos bloques se distribuyen de forma circular y paralela entre todas las unidades físicas del arreglo. Al segmentar el dato, el subsistema puede ejecutar operaciones de lectura y escritura concurrentes utilizando los cabezales de todos los discos simultáneamente. Esto multiplica la tasa de transferencia agregada y elimina los cuellos de botella durante los procesos de renderizado y edición masiva.
Mecanismo de doble paridad (P + Q)
Este es el núcleo matemático del RAID 6. Para cada franja (stripe) de datos distribuidos, el sistema genera dos conjuntos independientes de información de control de errores:
- Paridad P: Utiliza el operador lógico tradicional XOR (O exclusivo), idéntico al empleado en arquitecturas RAID 5. Es un cálculo de bajo impacto computacional que permite reconstruir los datos si falla un solo disco.
- Paridad Q: Es un segundo esquema de verificación basado en álgebra lineal avanzada y polinomios sobre Campos de Galois ($GF(2^8)$), implementado comúnmente a través del Código Reed-Solomon.
Al disponer de estas dos ecuaciones matemáticas independientes para cada bloque de datos, el subsistema posee suficiente redundancia para resolver las incógnitas algorítmicas necesarias para reconstruir la información idéntica de dos discos ausentes.
Distribución heterogénea
A diferencia de configuraciones arcaicas como RAID 3 o RAID 4, donde existían discos físicos dedicados exclusivamente a almacenar la paridad, RAID 6 distribuye tanto los bloques de datos como los bloques de paridad ($P$ y $Q$) de forma rotativa a lo largo de todas las unidades del arreglo. Esta distribución garantiza que no exista un «disco de cuello de botella» ni un desgaste mecánico desigual, homogeneizando la vida útil del hardware y optimizando los accesos de lectura aleatoria.
Modelado matemático: Capacidad útil vs. Redundancia
En ingeniería de sistemas, la implementación de arquitecturas redundantes exige un análisis de compromiso (trade-off) entre la capacidad de almacenamiento neto y el nivel de fiabilidad requerido. La ecuación matemática fundamental para determinar la capacidad de almacenamiento efectiva en un arreglo RAID 6 se expresa de la siguiente manera:
Capacidadútil = (n – 2) x C
Donde:
- n representa el número total de unidades de disco duro idénticas instaladas en el arreglo (n ≥ 4).
- 2 representa la penalización constante de capacidad (el espacio equivalente a dos unidades) requerida para almacenar los conjuntos de paridad P y Q.
- C corresponde a la capacidad nominal de la unidad de menor tamaño dentro del arreglo.
Para profundizar en el diseño e implementación de este modelo, se puede consultar la documentación y literatura científica indexada en ScienceDirect Digital Storage, plataforma de alta autoridad que analiza en detalle la física y la arquitectura de los dispositivos de almacenamiento masivo profesionales.
Ejemplo práctico de configuración en producción
Imaginemos un nodo de almacenamiento compuesto por un arreglo de ocho (n = 8) discos duros idénticos de 12 TB de capacidad cada uno. Aplicando el modelo matemático:
Capacidadútil = (8 – 2) x 12 TB = 6 x 12 TB = 72 TB
- Capacidad Bruta Total: 8 x 12 TB = 96 TB.
- Capacidad Útil Efectiva: 72 TB disponibles para el sistema operativo y el sistema de archivos (como XFS).
- Espacio Asignado a Paridad (P+Q): 2 x 12 TB = 24 TB.
Este diseño representa un «sacrificio» exacto del 25% de la capacidad bruta para destinarlo a seguridad matemática distribuida. Si comparamos este escenario con un esquema de espejo como RAID 10 (donde se pierde el 50% de la capacidad total en duplicación), RAID 6 demuestra ser una solución óptima en términos de eficiencia de costes para empresas que manejan petabytes de datos multimedia pesados.
Factor de riesgo en discos de alta densidad y el MTTDL
Para comprender la verdadera necesidad de un arreglo de doble paridad, es imperativo analizar el concepto de MTTDL (Mean Time To Data Loss o Tiempo Medio para la Pérdida de Datos). El MTTDL calcula la probabilidad estadística de que un sistema de almacenamiento sufra una pérdida irreversible de datos en un periodo de tiempo determinado.
En la actualidad, las unidades mecánicas comerciales e industriales superan con facilidad los 12, 16 o 20 Terabytes de capacidad. Aunque esto optimiza el espacio físico en los centros de datos, introduce un riesgo crítico durante las fases de reconstrucción. Cuando una unidad falla en un arreglo RAID 5, el sistema entra en un estado «degradado». Para reconstruir ese disco ausente, la controladora debe leer el 100% de los datos de los discos restantes para calcular el bit que falta mediante operaciones XOR.
Este proceso de lectura masiva e intensiva puede demorar días debido a las limitaciones de velocidad de escritura física de los discos nuevos. Durante esta larga ventana de tiempo, los discos restantes sufren un estrés térmico y mecánico severo. Si ocurre un Error de Lectura Irrecuperable (Unrecoverable Read Error – URE) o si una segunda unidad experimenta un fallo mecánico antes de finalizar la reconstrucción, un arreglo RAID 5 queda destruido de inmediato.
Al implementar RAID 6, el sistema puede tolerar un URE o la avería total de un segundo disco simultáneamente en medio de un proceso de reconstrucción.Las ecuaciones del Código Reed-Solomon permiten al subsistema recalcular los datos que faltan cruzando las paridades P y Q, manteniendo el MTTDL en niveles de seguridad industrial e impidiendo la pérdida de datos.
Rendimiento en operaciones de lectura y escritura: Write Penalty
Una evaluación de arquitectura de sistemas no está completa sin cuantificar el impacto del software y el hardware en el rendimiento de entrada/salida (E/S). RAID 6 presenta comportamientos diametralmente opuestos dependiendo del tipo de operación que se ejecute:
- Rendimiento de lectura: Es extremadamente alto. Al estar los datos distribuidos (striping) entre múltiples discos, el controlador puede solicitar diferentes sectores de un archivo de vídeo a varias unidades de manera simultánea. Para flujos de trabajo de edición de vídeo —donde decenas de pistas de audio y vídeo en alta definición se leen de forma constante y concurrente— RAID 6 ofrece una velocidad casi lineal escalable según el número de discos útiles en el arreglo.
- Penalización de escritura (Write Penalty): Cada vez que un sistema operativo modifica o escribe un bloque de datos en un arreglo RAID 6, no basta con escribir el dato aislado. El sistema debe realizar un proceso complejo de actualización: leer el dato antiguo, leer la paridad P antigua, leer la paridadQ antigua, calcular la nueva paridad XOR, calcular la nueva paridad Reed-Solomon con algebra de campos finitos, y finalmente escribir el nuevo dato junto con las dos nuevas paridades.Esto genera un Write Penalty de 6. Es decir, por cada operación de escritura lógica que solicita el sistema operativo, el subsistema RAID 6 debe realizar internamente6 operaciones físicas de E/S (3 lecturas y 3 escrituras).

Implementación de infraestructura: Controladoras de Hardware vs. Software
Para mitigar el severo impacto del Write Penalty y los cálculos algebraicos del Código Reed-Solomon, la decisión de diseño más crítica en la implantación de un nodo RAID 6 es la independencia del hardware.
RAID por Software
Si se delega la gestión del arreglo al sistema operativo de la máquina mediante herramientas de software (comomdadm en Linux), la CPU principal del servidor se saturará intentando resolver de forma constante los complejos cálculos matemáticos de la doble paridad mientras procesa las tareas nativas del negocio.Esto genera latencia, caídas en la tasa de transferencia y cuellos de botella críticos.
Controladoras físicas dedicadas
La solución profesional exige el uso de tarjetas controladoras PCIe independientes equipadas con su propio procesador de cálculo dedicado (ASIC) y memoria caché integrada de alta velocidad.El chip de la controladora procesa los algoritmos XOR y Reed-Solomon en nanosegundos de forma transparente para el sistema operativo.
Además, estas controladoras incorporan sistemas de protección de energía como unidades BBU (Battery Backup Unit) o módulos de memoria flash supercondensadoras.Ante un corte inesperado de energía eléctrica, los datos que se encuentran retenidos en la caché de escritura de la tarjeta no se volatilizan; se mantienen seguros y se graban en los discos en cuanto la infraestructura eléctrica se restablece, evitando la corrupción de archivos y el temido fenómeno del Write Hole (agujero de escritura).
Conclusión: Ecosistema de seguridad y alta disponibilidad
La arquitectura RAID 6 no debe contemplarse como una simple configuración de hardware o una suma de discos conectados.Representa un subsistema robusto de ingeniería diseñado para garantizar la resiliencia y la continuidad operativa en entornos donde el tiempo de inactividad es inaceptable.
A través del entrelazado de datos, la doble paridad matemática y la distribución inteligente de la carga, RAID 6 logra blindar la integridad del dato frente a las inevitables fallas físicas del hardware.Para industrias como la cinematográfica o los centros de datos modernos, el uso de este estándar —potenciado por controladoras dedicadas y sistemas de archivos optimizados como XFS— constituye la inversión técnica más eficiente para proteger sus activos críticos de información y asegurar su resiliencia operativa en el tiempo.